87 minutos esperando un clúster que nunca iba a terminar de crearse
9 de octubre de 2026
Mi clúster de Azure pasó 87 minutos en estado creando sin un solo error. La causa era una regla de red que ningún registro mostraba. Qué ve cada instrumento de Azure y qué no.
El clúster de Kubernetes de mi laboratorio en Azure pasó 87 minutos en estado creando sin que apareciera un solo error en ningún registro. Solo una barra de progreso que no avanzaba.
Lo primero que revisé fue el firewall, porque todo el tráfico del clúster sale por él y sus registros estaban encendidos. Salieron limpios, y ahí estuvo mi error: busqué en el único instrumento que no podía ver el problema.
La regla que yo mismo había escrito
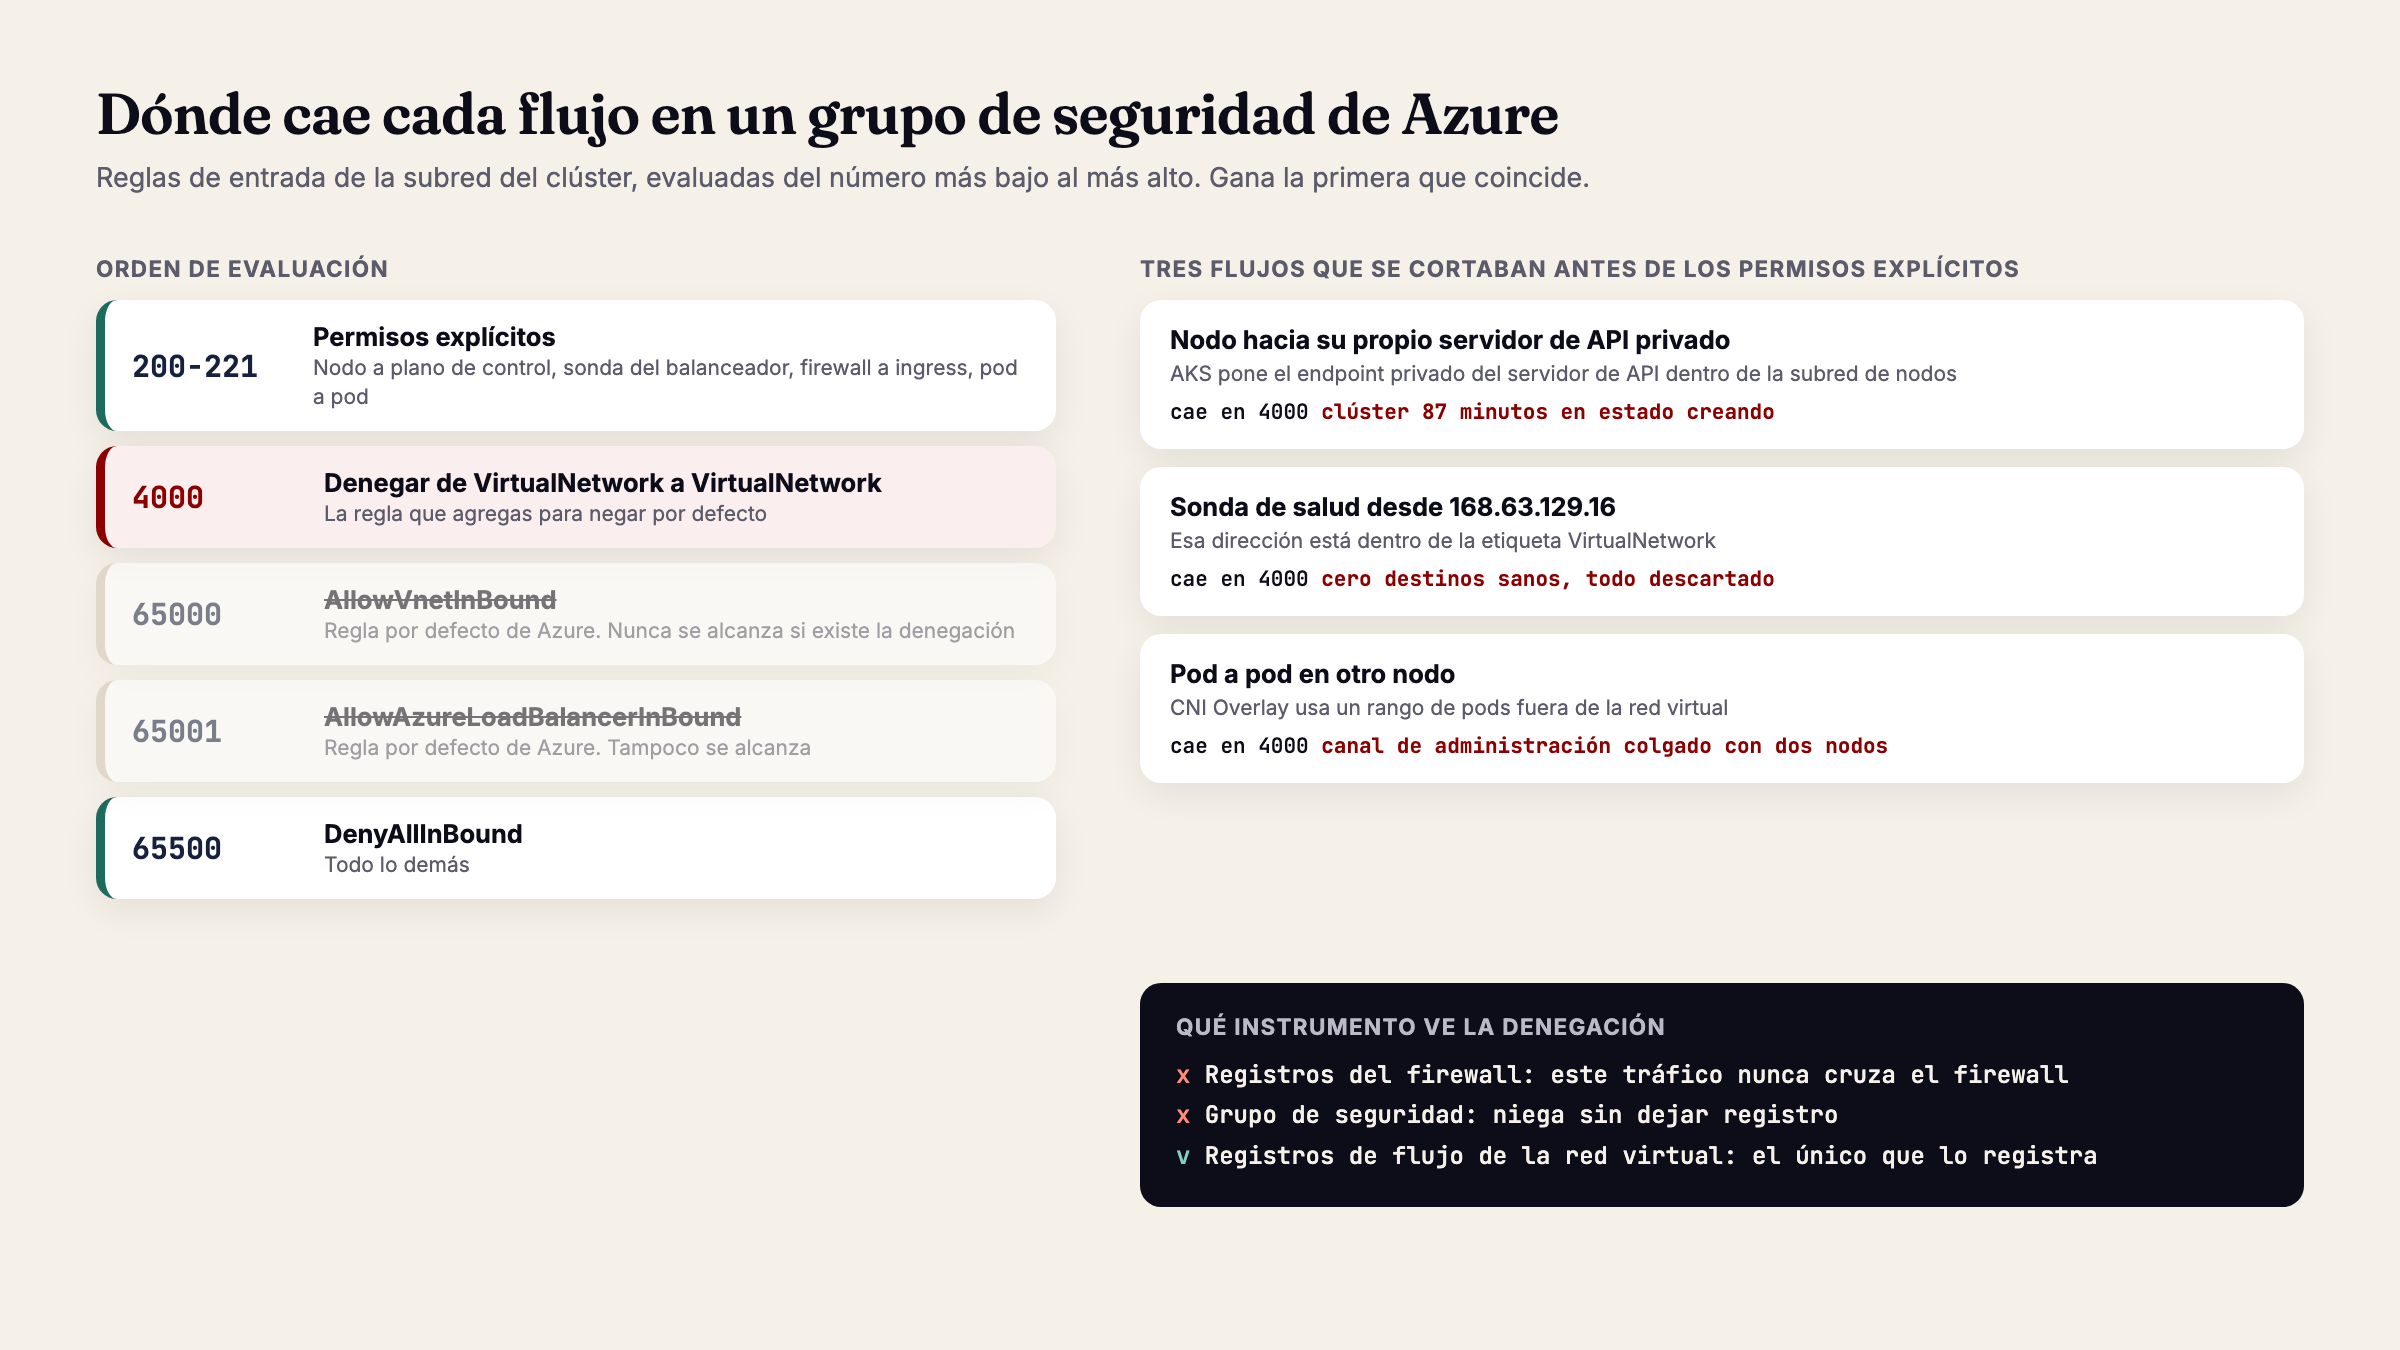
Azure trae en cada grupo de seguridad de red una regla que permite todo el tráfico dentro de la red virtual. En una red personalizada de Google Cloud la entrada se niega por defecto; en Azure hay que vencer esa regla, y yo la vencí con una denegación en la prioridad 4000 para que nada hablara con nada sin permiso explícito.
Para ser exacto: las reglas por defecto de un grupo de seguridad son AllowVnetInBound en la prioridad 65000, AllowAzureLoadBalancerInBound en 65001 y DenyAllInBound en 65500. La etiqueta VirtualNetwork cubre el espacio de direcciones de la red, las redes emparejadas y la dirección de la plataforma 168.63.129.16. Cualquier regla con un número menor gana sobre las tres.
Lo que no sabía es que AKS pone el punto de entrada privado del servidor de API, el plano de control del clúster, dentro de la subred de los nodos. Un nodo que habla con su propio plano de control es tráfico de la subred hacia sí misma, y mi denegación lo cortaba.
Ese tráfico se entrega dentro de la subred y nunca pasa por el firewall, por eso sus registros estaban limpios. Y un grupo de seguridad no registra lo que niega salvo que enciendas los registros de flujo, que en ese momento yo no tenía.
La corrección fue una regla: permitir que la subred del clúster hable consigo misma.
La segunda vez, con otra cara
Más adelante puse un balanceador interno delante del ingress. Se creó, tomó su dirección privada, reportó cero destinos sanos y descartó todo, otra vez en silencio.
La sonda de salud del balanceador sale de una dirección de la plataforma de Azure que queda dentro de la etiqueta de red virtual. Azure trae una regla que la admite, pero en la prioridad 65001, por debajo de mi denegación en 4000, así que nunca llegaba a evaluarse. El mismo mecanismo, el mismo silencio.
Qué ve cada instrumento
La lección no fue la regla. Fue que saber qué no observa cada instrumento vale tanto como saber qué observa.
Los registros del firewall ven lo que cruza el firewall, y el tráfico dentro de una subred no lo cruza. El grupo de seguridad niega sin dejar rastro. Lo que sí ve el tráfico descartado dentro de una red son los registros de flujo de la red virtual, así que en el laboratorio publicado vienen encendidos desde el primer despliegue, en una cuenta de almacenamiento propia que cuesta unos centavos al mes.
En Google Cloud el registro se enciende en cada regla de firewall y anota lo que esa regla decide, denegaciones incluidas. En Azure lo más cercano son los registros de flujo, que se encienden para toda la red virtual. Si vienes de Google Cloud y buscas el interruptor por regla, no lo vas a encontrar.
| Opción | Costo | Riesgo | Veredicto |
|---|---|---|---|
| Dejar la regla de Azure que permite todo dentro de la red | CostoNada | RiesgoUna máquina comprometida habla con todas las demás | VeredictoDescartado |
| Negar todo en la prioridad 4000 y abrir por excepción | CostoDeclarar cada flujo legítimo, y el que se olvida falla sin avisar | RiesgoHoras buscando en el registro equivocado | VeredictoElegido |
| Encender los registros de flujo de la red virtual | CostoUna cuenta de almacenamiento y unos centavos al mes | RiesgoNinguno relevante en un laboratorio | VeredictoElegido: es lo único que ve la denegación |
Lo que dejé escrito
Las dos reglas quedaron declaradas en el código con un comentario que explica por qué existen, porque dentro de seis meses alguien va a ver un permiso que parece sobrar y va a querer borrarlo. Están en la capa de plataforma del repositorio.
El patrón volvió una tercera vez, cuando escalé el clúster a dos nodos: el tráfico entre pods de nodos distintos usa direcciones que no pertenecen a la red virtual, y la misma denegación lo descartaba. Con un solo nodo nunca se habría visto. Era la misma familia de problema, y esta vez empecé por las reglas de la red y no por el firewall.
Si mañana algo en tu sistema deja de funcionar en silencio, ¿sabes cuál de tus registros es ciego justo en ese punto, o lo vas a descubrir buscando en él?