Google Vertex AI como puerta única a Gemini y Claude: por qué dejar de escribir un adaptador por proveedor de IA
4 de noviembre de 2026
Si tu plataforma corre en Google Cloud, Vertex AI ya da Gemini, Claude y Mistral por una sola puerta. Encima basta un gateway propio y delgado.
En una frase: si tu plataforma corre en Google Cloud, no necesitas conectarte con cada empresa de IA por separado. Google Vertex AI ya es una puerta única a los modelos de Google (Gemini) y a los de socios como Anthropic (Claude) y Mistral, con una sola identidad, un solo contrato y una sola factura. Encima basta un gateway propio y delgado que haga solo lo que te diferencia.
El problema: cada proveedor de IA es una integración más
Cualquier producto que usa IA quiere poder cambiar de modelo. Sale uno más barato, uno más rápido o uno que razona mejor, y la idea es probarlo sin reescribir nada.
Lo habitual al empezar es escribir un adaptador por proveedor: uno para Google, otro para Anthropic, otro para OpenAI. Y cada uno trae lo suyo:
- su API y su forma de responder,
- su llave, que hay que guardar, rotar y cuidar de que no se filtre,
- su contrato y su revisión legal,
- su factura, casi siempre en dólares y por fuera de la nube.
Con un proveedor no se nota, en el tercero ya duele.
Vertex AI ya es un agregador de modelos
Vertex AI sirve también modelos de otros editores: en Model Garden los ofrece como servicio, y esa lista se puede consultar por API. Una consulta a la lista en noviembre de 2026 devolvió esto:
- Google (Gemini): 32 modelos.
- Anthropic (Claude): 13 modelos.
- Mistral: 4 modelos.
- OpenAI: ninguno en esa lista. Sus modelos comerciales siguen saliendo por la API de OpenAI, con su propia llave.
Eso cambia la cuenta: para Gemini y Claude hay una sola puerta, y esa puerta da cuatro cosas que un adaptador por proveedor no da.
- Un solo acceso, sin llaves. El servicio entra a Vertex AI con su propia identidad de Google Cloud, y no queda llave de Anthropic ni de nadie que guardar.
- Un solo contrato. Los modelos de socios quedan bajo el contrato de Google Cloud, y si la plataforma maneja datos de clientes, revisar un contrato en vez de cinco pesa mucho.
- Una sola factura. El consumo de Gemini y de Claude llega a la factura de Google Cloud, donde suelen estar los créditos de la nube.
- Un solo control de región y de red. Dónde se procesan los datos, las cuotas y el monitoreo quedan en un mismo lugar.
El patrón: un adaptador por familia de API
El cambio de fondo es contar los adaptadores de otra manera. Se cuenta uno por familia de API, aunque detrás de cada familia haya varias empresas de IA:
- Familia Vertex AI, la principal. Entra con la identidad del servicio y arma el pedido según el formato de cada modelo. Dentro de Vertex AI conviven tres formatos: el nativo de Gemini, el de mensajes que usa Claude y uno compatible con el estilo de OpenAI.
- Familia compatible con llave, la excepción. Para proveedores que Vertex AI no ofrece, como los modelos comerciales de OpenAI.
Son dos adaptadores, y siguen siendo dos aunque se usen diez modelos. Agregar Claude, o un Gemini nuevo, pasa a ser un dato que se habilita desde una consola, sin escribir código.
Cómo queda la arquitectura
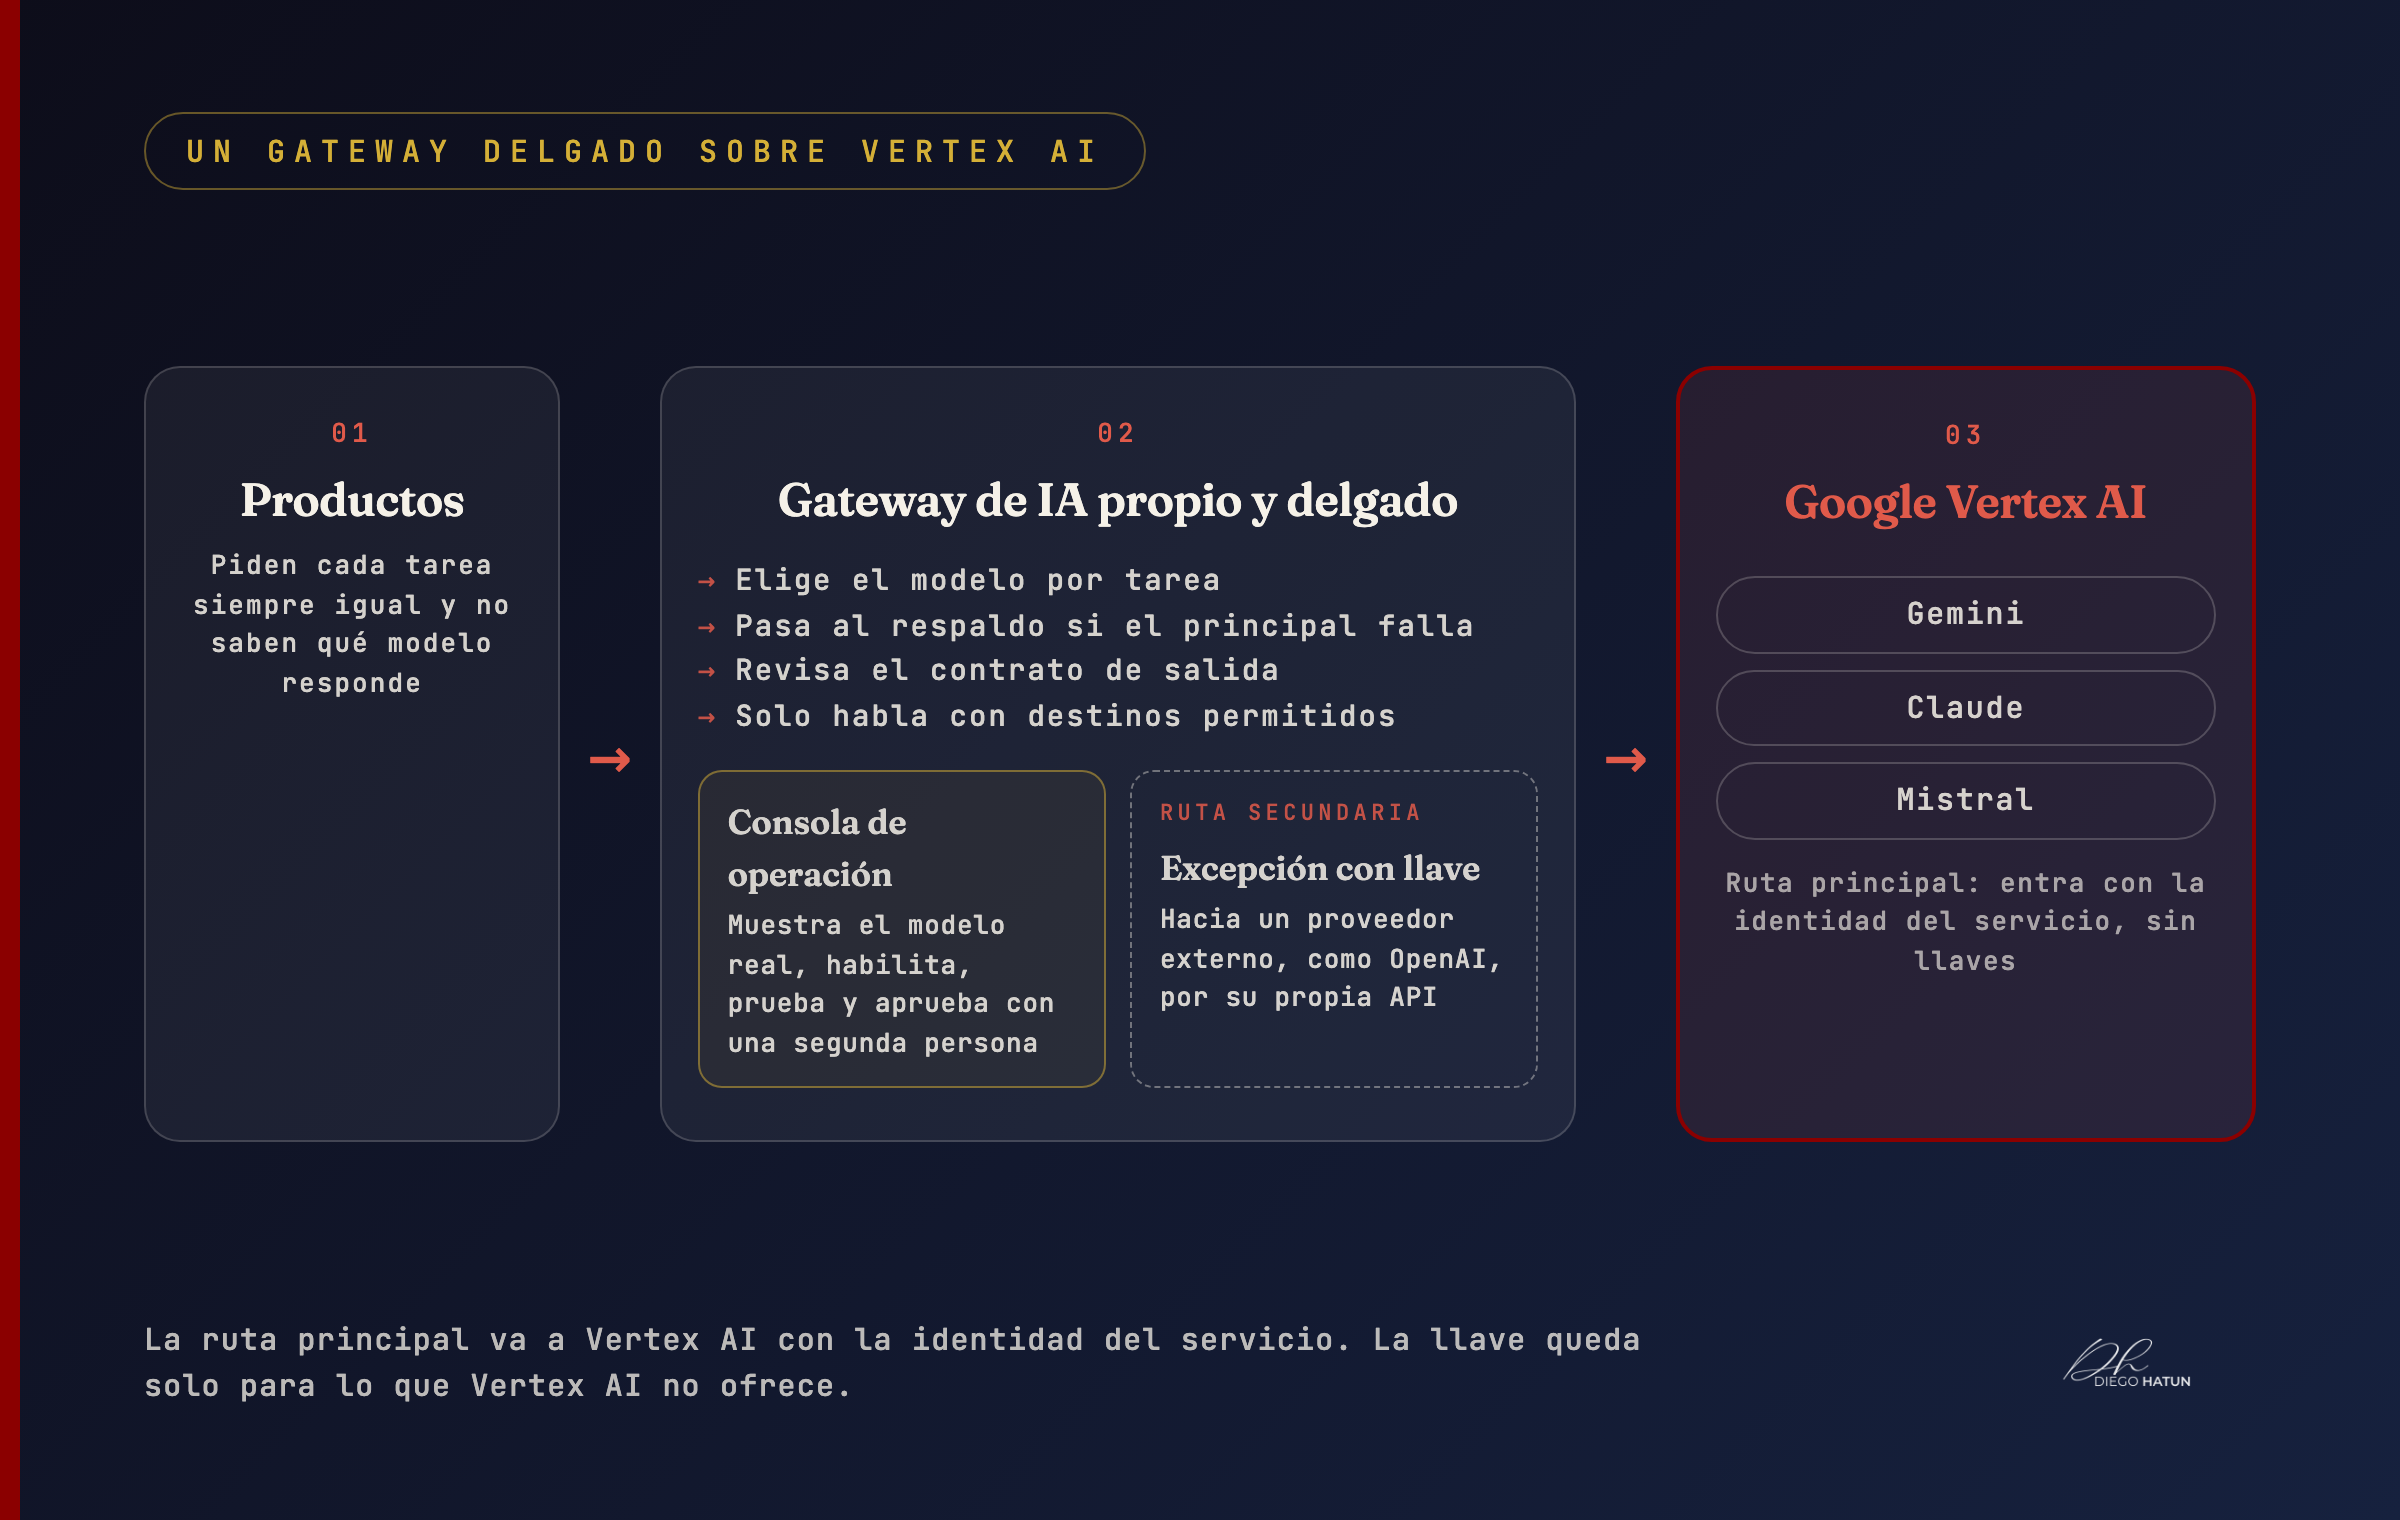
Son tres piezas, cada una con su responsabilidad:
- Los productos piden «resúmeme esta conversación» siempre de la misma forma, y no saben qué modelo ni qué proveedor responde.
- Un gateway de IA propio y delgado decide qué modelo atiende cada tarea, pasa a un modelo de respaldo si el principal falla, revisa que la respuesta cumpla el contrato antes de que llegue al usuario, registra uso y costo, y solo habla con destinos permitidos. Su identidad de Google solo puede salir hacia Vertex AI.
- Una consola de operación hace de tablero: muestra el modelo real que atiende cada tarea, permite habilitar modelos desde la lista que devuelve Vertex AI, probarlos contra el contrato y elegirlos con la aprobación de una segunda persona.
Por qué no un gateway ya hecho
Hay tres alternativas que vale la pena mirar, y aquí van al lado de la que propongo:
| Opción | Costo | Riesgo | Veredicto |
|---|---|---|---|
| Gateway de código abierto que conecta cientos de proveedores con llave | CostoUna pieza más que operar | RiesgoDevuelve el problema de las llaves | VeredictoÚtil si hacen falta muchos proveedores fuera de la nube |
| Apigee como gateway de IA | CostoCosto fijo y una operación pensada para empresas con muchas APIs | RiesgoNo trae una prueba de contrato propia ni doble aprobación | VeredictoMuy completo, para otra escala |
| Gateway administrado por un tercero | CostoLo más rápido de montar | RiesgoLos datos de los usuarios pasan por otra empresa | VeredictoRápido, a cambio de sacar los datos de casa |
| Vertex AI con un gateway propio y delgado | CostoDos adaptadores y una consola que mantener | RiesgoDependencia de Vertex AI; lo que no está ahí va por la excepción con llave | VeredictoLa elegida: Vertex AI pone la conexión y el gateway lo que diferencia |
Un gateway de código abierto sirve cuando hacen falta muchos proveedores fuera de la nube, pero devuelve el problema de las llaves y suma una pieza más que operar. Apigee es la oferta de Google para enrutar y limitar el tráfico hacia modelos, muy completa, con costo fijo y sin prueba de contrato ni doble aprobación. Un gateway administrado por un tercero es lo más rápido de montar, y los datos de los usuarios pasan por otra empresa.
Vertex AI pone la conexión con los modelos, y el gateway propio y delgado pone solo lo que diferencia al producto.
Un error fácil de cometer: esconder el modelo
Es tentador guardar el catálogo de modelos en un archivo cargado por script, con apodos en vez de nombres reales, para no exponer qué modelo se usa. Protege el secreto industrial hacia afuera y deja a ciegas a quien opera la plataforma: la IA puede funcionar perfecto y nadie sabe qué modelo respondió, cuánto costó ni cómo le fue en las pruebas.
El nombre del modelo se queda fuera del código y de la documentación pública, y a la vista en la pantalla del operador.
Lo que cuesta este enfoque
- Dependencia de Vertex AI. No todos los modelos del mercado están ahí, y uno nuevo puede llegar después o en menos regiones. Para eso existe la familia con llave.
- Cada socio habla distinto. Gemini y Claude usan formatos diferentes dentro de Vertex AI, y el adaptador los resuelve por el formato guardado en cada modelo.
- Los precios hay que medirlos. El precio de Claude dentro de Vertex AI conviene compararlo con el directo, y medir el costo real por uso en cada prueba.
- Hay pasos humanos. Los modelos de socios se habilitan una vez en Model Garden, aceptando sus términos, y arrancan con cuota cero. Mientras no se pida cuota, Vertex AI responde 429 aunque el pedido esté bien armado.
Lo que queda
- Antes de construir un agregador de modelos, mira si tu nube ya es uno. En Google Cloud, Vertex AI lo es.
- Cuenta los adaptadores por familia de API. Si cada proveedor nuevo es código nuevo, la arquitectura está midiendo lo que no importa.
- El secreto industrial va fuera del código y dentro de la pantalla del operador.
- Prueba contra la plataforma real. Las pruebas con dobles no ven un encabezado de proyecto que falta ni una cuota en cero.
Todo queda detrás de un puerto propio: si mañana conviene otra plataforma, cambia una familia de API y ningún producto se entera.
Cuando salga el próximo modelo que quieras probar, ¿lo vas a recibir con un adaptador nuevo o con un dato que alguien habilita en la consola?